予備知識:解析の言葉
極値推定の議論では、解析の言葉が頻繁に出てくる。ただし、この章で必要なのは「有限個のパラメタを推定する」ための有限次元の直観で十分である。
上限 sup
\(\sup\) は 上限 と読む。集合 \(A\) のすべての要素以上である数を上界といい、その中で最小のものを \(\sup A\) と書く。
例えば \[
\sup [0,1]=1,
\qquad
\sup (0,1)=1
\] である。\([0,1]\) では 1 が集合に入っているので最大値でもある。一方、\((0,1)\) では 1 は集合に入っていないので最大値ではないが、いくらでも 1 に近づけるので上限は 1 である。
極値推定で \[
\sup_{\theta\in\Theta} Q_n(\theta)
\] と書くときは、「パラメタ \(\theta\) を動かしたときに達成できる目的関数の最良値」を表している。最大値が実際に存在するときは \(\max_{\theta\in\Theta} Q_n(\theta)\) と同じだが、存在するかどうかをまだ仮定したくないので \(\sup\) を使う。
コンパクト
有限次元、つまり \(\Theta\subseteq\mathbb R^p\) の場合には、コンパクト はほぼ
閉じていて、かつ有界である
と思ってよい。
閉じているとは、端点や境界を含むということである。有界であるとは、無限遠まで広がっていないということである。例えば \([0,1]\) や閉球 \[
\{\theta\in\mathbb R^p:\|\theta\|\le C\}
\] はコンパクトである。一方、\((0,1)\) は端点を含まないのでコンパクトではなく、\(\mathbb R\) は無限に広がるのでコンパクトではない。
推定論でコンパクト性を仮定する理由は、パラメタが「端点の外」や「無限遠」に逃げる可能性を排除するためである。本章では有限個のパラメタしか扱わないので、この有限次元の理解で十分である。
連続関数
関数 \(Q(\theta)\) が連続であるとは、\(\theta\) を少しだけ動かすと \(Q(\theta)\) も少しだけしか変わらない、ということである。
多項式、指数関数、対数関数、そしてそれらを足したり掛けたり合成したりして作った関数は、多くの場合連続である。一方、 \[
1\{\theta\ge 0\}
\] のような指示関数は、\(\theta=0\) で急に値が変わるので連続ではない。
極値推定では、\(Q\) が連続であると、目的関数の山や谷が突然切れることがない。この性質が、最大化点の存在や clean maximum の確認に使われる。
Weierstrass の定理
Weierstrass の定理は、極値推定で何度も使う基本事実である。
\(\Theta\subseteq\mathbb R^p\) がコンパクトで、\(Q:\Theta\to\mathbb R\) が連続なら、\(Q\) は \(\Theta\) 上で最大値と最小値をとる。
つまり、単に \[
\sup_{\theta\in\Theta}Q(\theta)
\] という上限があるだけでなく、それを実際に達成する点 \(\theta^*\) が存在して \[
Q(\theta^*)=\sup_{\theta\in\Theta}Q(\theta)
\] と書ける。
この章では、\(\theta_0\) から一定距離以上離れた集合上で \(Q\) の最大値をとる点が存在することを使い、その点では識別により \(Q(\theta_0)\) より目的関数が低い、と示す。
収束と一様収束
数列 \(a_n\) が \(a\) に収束するとは、\(n\) が大きくなると \(a_n\) が \(a\) に近づくことである。確率変数 \(Z_n\) が \(Z\) に確率収束するとは、任意の \(\varepsilon>0\) について \[
P(|Z_n-Z|>\varepsilon)\to 0
\] となることである。
関数列 \(Q_n(\theta)\) の場合には、2 種類の収束を区別する必要がある。
点ごとの収束は、各 \(\theta\) を固定すると \[
Q_n(\theta)\to Q(\theta)
\] となることである。
一様収束は、\(\theta\) 全体で見た最大の誤差が小さくなることである。 \[
\sup_{\theta\in\Theta}|Q_n(\theta)-Q(\theta)|\to 0.
\]
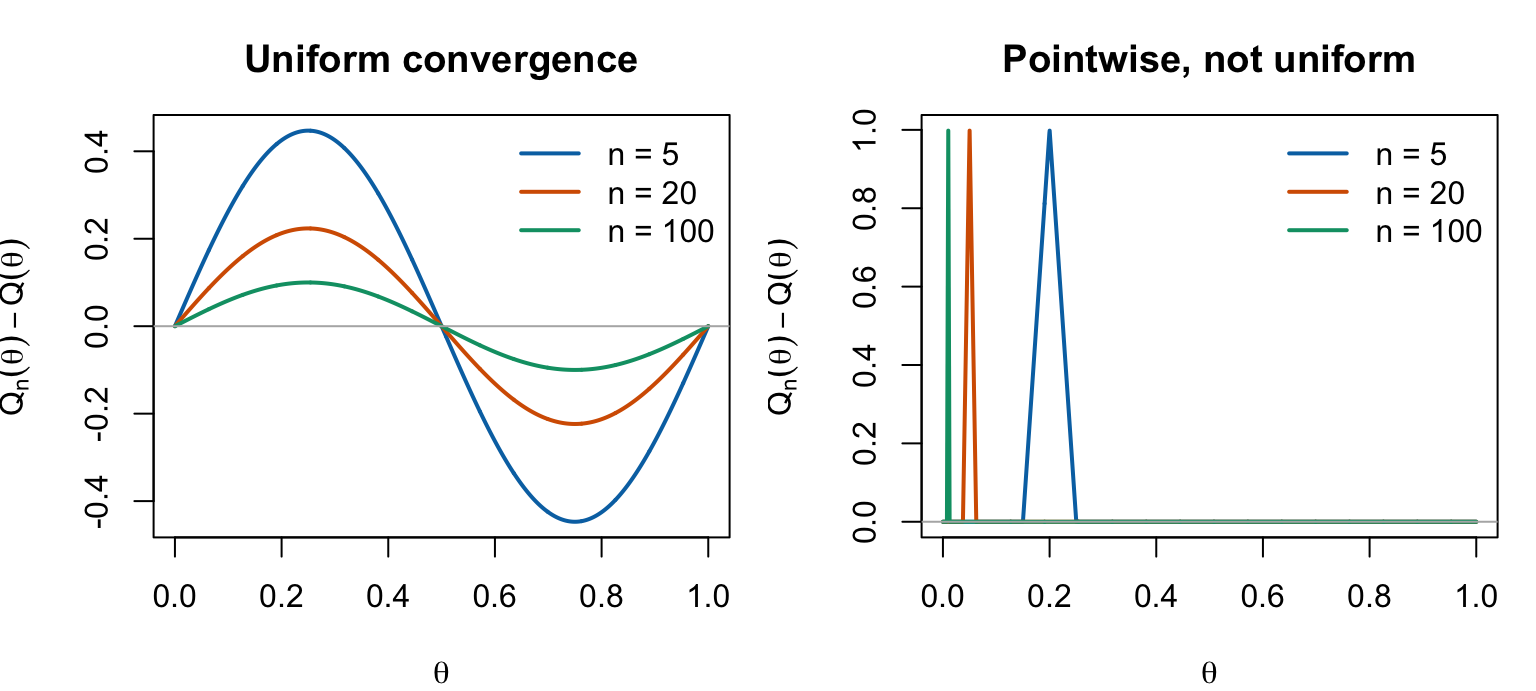
図式的には、点ごとの収束は「どの点も、個別に見れば近づく」、一様収束は「同じ \(n\) で、曲線全体がまとめて近づく」という違いである。
\[
\begin{array}{c}
\text{点ごとの収束:}\quad
\theta\text{ を固定してから }n\to\infty \\
\text{一様収束:}\quad
\theta\text{ を全部動かしても最大誤差が小さい}
\end{array}
\]
次の R コードでは、誤差 \[
e_n(\theta)=Q_n(\theta)-Q(\theta)
\] を 2 通りに作って、この違いを直接描いている。どちらも極限関数は \(0\) である。左側では誤差の曲線全体が \(0\) に押しつぶされていく。右側では、各固定点から見るとスパイクはいつか通り過ぎるので \(0\) に収束するが、どの \(n\) でも高さ 1 のスパイクが残っている。
theta <- seq(0, 1, length.out = 2000)
n_grid <- c(5, 20, 100)

# 一様収束する誤差: 曲線全体の振幅が小さくなる。
uniform_error <- function(theta, n) {
  sin(2 * pi * theta) / sqrt(n)
}

# 点ごとには 0 に収束するが、一様には収束しない誤差。
# 高さ 1 の三角形スパイクが theta = 1/n の位置に動いていく。
moving_spike <- function(theta, n) {
  pmax(0, 1 - 4 * n * abs(theta - 1 / n))
}

cols <- c("#0072B2", "#D55E00", "#009E73")

old_par <- par(mfrow = c(1, 2), mar = c(4, 4, 3, 1))

matplot(
  theta,
  sapply(n_grid, function(n) uniform_error(theta, n)),
  type = "l", lty = 1, lwd = 2, col = cols,
  xlab = expression(theta),
  ylab = expression(Q[n](theta) - Q(theta)),
  main = "Uniform convergence"
)
abline(h = 0, col = "gray70")
legend("topright", legend = paste("n =", n_grid),
       col = cols, lty = 1, lwd = 2, bty = "n")

matplot(
  theta,
  sapply(n_grid, function(n) moving_spike(theta, n)),
  type = "l", lty = 1, lwd = 2, col = cols,
  xlab = expression(theta),
  ylab = expression(Q[n](theta) - Q(theta)),
  main = "Pointwise, not uniform"
)
abline(h = 0, col = "gray70")
legend("topright", legend = paste("n =", n_grid),
       col = cols, lty = 1, lwd = 2, bty = "n")

par(old_par)
この右側の例は、 \[
e_n(\theta)=\max\{0,1-4n|\theta-1/n|\}
\] という誤差を描いている。このスパイクが正になる範囲は \[
\left|\theta-\frac1n\right|<\frac{1}{4n},
\qquad
\text{つまり}\qquad
\theta\in\left(\frac{3}{4n},\frac{5}{4n}\right)
\] である。したがって、任意の固定された \(\theta\in[0,1]\) については \(e_n(\theta)\to0\) である。実際、\(\theta>0\) なら、十分大きな \(n\) ではスパイクは \(\theta\) よりずっと左側に移動している。また \(\theta=0\) では、各 \(n\) について \[
e_n(0)=\max\{0,1-4n|0-1/n|\}=\max\{0,-3\}=0
\] である。
しかし、一様収束はしない。なぜなら、各 \(n\) について \(\theta=1/n\) を選べば \[
e_n(1/n)=1
\] であり、 \[
\sup_{\theta\in[0,1]}|e_n(\theta)|=1
\] のままだからである。つまり、「どの固定点でも近づく」と「どこを見ても同時に近い」は別の条件である。
n_check <- c(5, 20, 100, 500, 2000)

sup_errors <- data.frame(
  n = n_check,
  uniform_error = 1 / sqrt(n_check),
  moving_spike_error = rep(1, length(n_check))
)

knitr::kable(
  sup_errors,
  digits = 3,
  col.names = c("n", "一様収束する例の sup 誤差", "スパイク例の sup 誤差")
)
極値推定の一致性では、一様収束が重要である。なぜなら、推定量 \(\hat\theta\) 自体が \(Q_n\) を見て動くため、固定された \(\theta\) だけで収束を確認しても足りないからである。
上のスパイク例でいえば、\(\hat\theta\) は固定された点ではない。\(Q_n\) の形を見て、その時々で高い場所を選ぶ。したがって、固定した \(\theta\) では消えているように見えるスパイクでも、最大化問題では \(\hat\theta\) がそのスパイクを追いかけてしまう可能性がある。一様収束は、このような「動き回る見かけの山」が目的関数全体に残っていないことを保証する条件である。
ブラケット数の直観
一様収束を示すには、無限個の関数 \[
\mathcal M=\{m(\cdot;\theta):\theta\in\Theta\}
\] を同時に扱う必要がある。ブラケット数は、この関数族がどれくらい複雑かを測る道具である。
ブラケットとは、関数 \(f\) を上下から挟む 2 本の関数 \(\ell\) と \(u\) の組である。 \[
\ell(x)\le f(x)\le u(x)
\] で、さらに上下の幅の平均 \[
E[u(X)-\ell(X)]
\] が小さいとき、そのブラケットはよい近似になっている。
\[
\begin{array}{c}
u(x)\quad \text{上側の関数} \\
\hline
f(x)\quad \text{挟まれる関数} \\
\hline
\ell(x)\quad \text{下側の関数}
\end{array}
\]
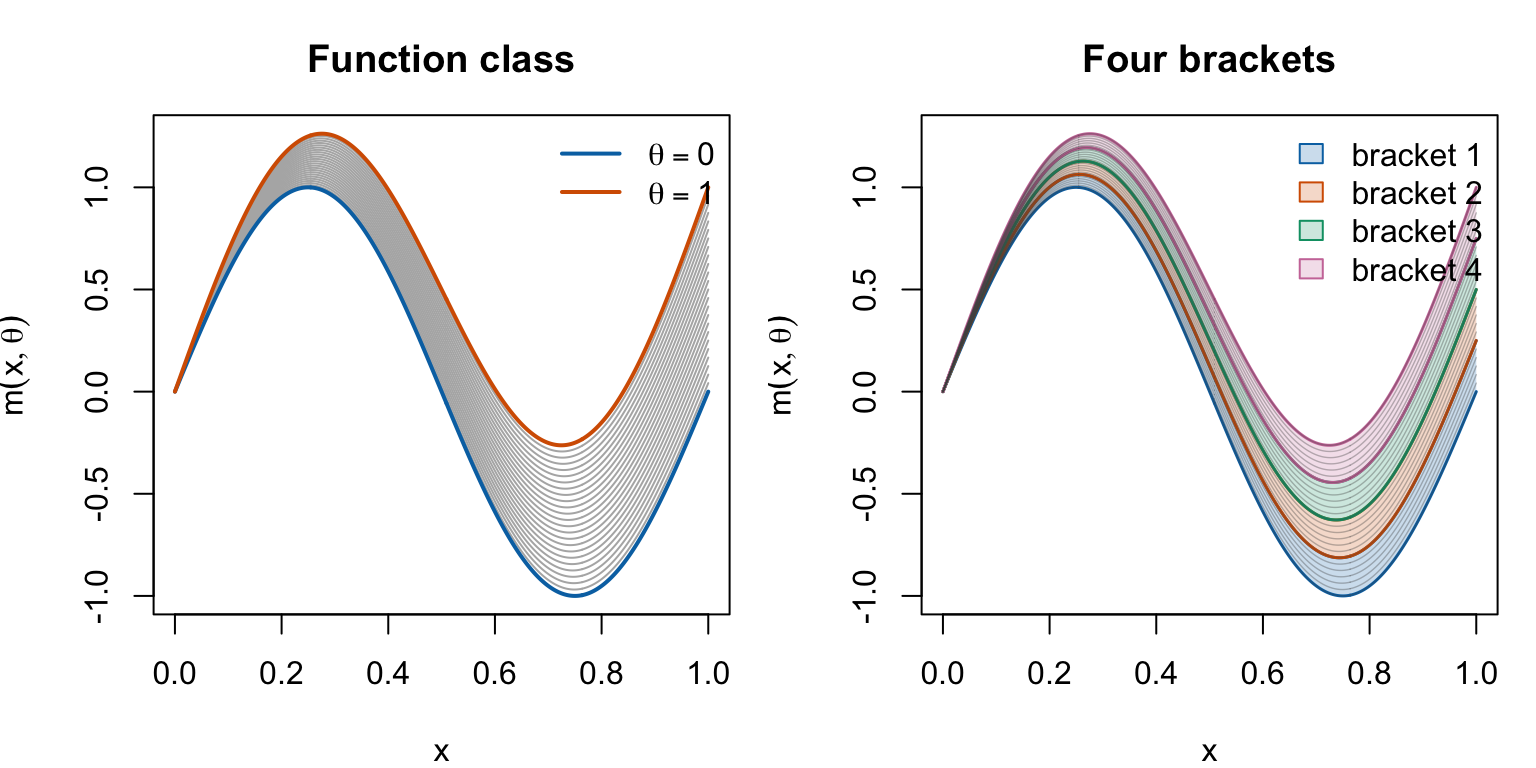
次の図では、簡単な関数族 \[
m(x;\theta)=\sin(2\pi x)+\theta x,
\qquad
\theta\in[0,1]
\] を考える。左側の灰色の線は、\(\theta\) を細かく動かして得られるたくさんの関数である。右側では、\(\theta\) の範囲を 4 つに分け、それぞれの区間に入る関数を上下 2 本の線で挟んでいる。
x <- seq(0, 1, length.out = 500)
m_fun <- function(x, theta) {
  sin(2 * pi * x) + theta * x
}

theta_many <- seq(0, 1, length.out = 25)
y_many <- sapply(theta_many, function(theta) m_fun(x, theta))
y_lim <- range(y_many)

J <- 4
theta_breaks <- seq(0, 1, length.out = J + 1)
band_cols <- adjustcolor(
  c("#0072B2", "#D55E00", "#009E73", "#CC79A7"),
  alpha.f = 0.22
)
edge_cols <- c("#0072B2", "#D55E00", "#009E73", "#CC79A7")

old_par <- par(mfrow = c(1, 2), mar = c(4, 4, 3, 1))

matplot(
  x, y_many,
  type = "l", lty = 1, lwd = 1, col = "gray70",
  xlab = "x", ylab = expression(m(x, theta)),
  ylim = y_lim,
  main = "Function class"
)
lines(x, m_fun(x, 0), col = "#0072B2", lwd = 2)
lines(x, m_fun(x, 1), col = "#D55E00", lwd = 2)
legend(
  "topright",
  legend = c(expression(theta == 0), expression(theta == 1)),
  col = c("#0072B2", "#D55E00"),
  lty = 1, lwd = 2, bty = "n"
)

plot(
  x, m_fun(x, 0),
  type = "n",
  xlab = "x", ylab = expression(m(x, theta)),
  ylim = y_lim,
  main = "Four brackets"
)

for (j in seq_len(J)) {
  theta_low <- theta_breaks[j]
  theta_high <- theta_breaks[j + 1]
  lower <- m_fun(x, theta_low)
  upper <- m_fun(x, theta_high)

  polygon(
    c(x, rev(x)),
    c(lower, rev(upper)),
    col = band_cols[j],
    border = NA
  )
  lines(x, lower, col = edge_cols[j], lwd = 1.5)
  lines(x, upper, col = edge_cols[j], lwd = 1.5)
}

for (theta in theta_many) {
  lines(x, m_fun(x, theta), col = adjustcolor("gray30", alpha.f = 0.35), lwd = 0.7)
}

legend(
  "topright",
  legend = paste0("bracket ", seq_len(J)),
  fill = band_cols,
  border = edge_cols,
  bty = "n"
)

par(old_par)
この例では \(x\in[0,1]\) なので、\(m(x;\theta)\) は \(\theta\) について単調に増える。したがって、\(\theta\) が区間 \([\theta_{j-1},\theta_j]\) に入っているなら、 \[
m(x;\theta_{j-1})
\le
m(x;\theta)
\le
m(x;\theta_j)
\qquad (0\le x\le 1)
\] である。このとき \[
\ell_j(x)=m(x;\theta_{j-1}),
\qquad
u_j(x)=m(x;\theta_j)
\] が 1 つのブラケットになる。
ブラケットの幅は「帯の厚さ」である。たとえば \(X\) が \([0,1]\) 上の一様分布なら、上の例で 4 等分した各ブラケットの平均幅は \[
E[u_j(X)-\ell_j(X)]
=
E[(\theta_j-\theta_{j-1})X]
=
\frac{1}{4}\cdot\frac{1}{2}
=
\frac18
\] である。もっと細かく分ければ帯は薄くなるが、必要なブラケットの数は増える。ブラケット数とは、「指定された幅以下の帯で関数族全体を覆うには、最低いくつ帯が必要か」を表す数である。
したがって、この例では 4 個のブラケットで平均幅 \(1/8\) の精度で関数族全体を挟めている。さらに、\(\theta\) の区間を \(J\) 等分すれば各ブラケットの平均幅は \(1/(2J)\) になるので、任意の \(\varepsilon>0\) に対して十分大きな有限の \(J\) を選べば、幅 \(\varepsilon\) 以下の有限個のブラケットで関数族全体を挟める。
有限個のブラケットで関数族全体を挟めるなら、無限個の関数を一つずつ見る代わりに、有限個の上側関数と下側関数だけを見ればよい。有限個に帰着できれば、大数の法則を同時に適用しやすくなる。
予備知識:線形代数の言葉
GMM や OLS の行列表記では、ベクトルと行列の記法を使う。ここでは、この章で必要な最小限をまとめる。
ベクトル
ベクトルは数を縦に並べたものである。 \[
x=
\begin{pmatrix}
x_1\\
x_2\\
\vdots\\
x_k
\end{pmatrix}
\in\mathbb R^k.
\]
\(x'\) は転置を表し、縦ベクトルを横ベクトルに変える。 \[
x'=(x_1,x_2,\ldots,x_k).
\]
2 つの同じ長さのベクトル \(x,y\in\mathbb R^k\) の内積は \[
x'y=\sum_{j=1}^k x_jy_j
\] である。ノルムはベクトルの長さであり、 \[
\|x\|=\sqrt{x'x}
\] と書く。
行列
行列は数を長方形に並べたものである。 \[
A=
\begin{pmatrix}
a_{11}&a_{12}&\cdots&a_{1k}\\
a_{21}&a_{22}&\cdots&a_{2k}\\
\vdots&\vdots&\ddots&\vdots\\
a_{r1}&a_{r2}&\cdots&a_{rk}
\end{pmatrix}
\in\mathbb R^{r\times k}.
\]
\(A\in\mathbb R^{r\times k}\) は、\(r\) 行 \(k\) 列の行列という意味である。\(A'\) は転置行列で、行と列を入れ替える。
足し算とスカラー倍
同じサイズの行列やベクトルは、成分ごとに足し算できる。 \[
\begin{pmatrix}1\\2\end{pmatrix}
+
\begin{pmatrix}3\\4\end{pmatrix}
=
\begin{pmatrix}4\\6\end{pmatrix}.
\]
数 \(c\) を掛けるスカラー倍も成分ごとに行う。 \[
c
\begin{pmatrix}1\\2\end{pmatrix}
=
\begin{pmatrix}c\\2c\end{pmatrix}.
\]
掛け算
行列とベクトルの積 \(Ax\) は、\(A\) の列数と \(x\) の長さが一致するときに定義される。\(A\in\mathbb R^{r\times k}\)、\(x\in\mathbb R^k\) なら、\(Ax\in\mathbb R^r\) である。 \[
(Ax)_i=\sum_{j=1}^k a_{ij}x_j.
\]
例えば \[
\begin{pmatrix}
1&2\\
3&4
\end{pmatrix}
\begin{pmatrix}
5\\
6
\end{pmatrix}
=
\begin{pmatrix}
1\cdot 5+2\cdot 6\\
3\cdot 5+4\cdot 6
\end{pmatrix}
=
\begin{pmatrix}
17\\
39
\end{pmatrix}.
\]
行列同士の積 \(AB\) は、\(A\) の列数と \(B\) の行数が一致するときに定義される。成分は \[
(AB)_{ij}=\sum_{\ell}a_{i\ell}b_{\ell j}
\] である。一般に \(AB=BA\) ではない。行列の掛け算では順番が重要である。
ランク
行列 \(A\) の ランク \(\operatorname{rank}(A)\) は、\(A\) の列ベクトルの中に含まれる独立な方向の数である。同じ値は、行ベクトルの中に含まれる独立な方向の数としても定義できる。
例えば \[
A=
\begin{pmatrix}
1&2\\
2&4
\end{pmatrix}
\] では、第 2 列が第 1 列の 2 倍なので、列方向の情報は実質的に 1 つしかない。したがって \(\operatorname{rank}(A)=1\) である。一方、 \[
B=
\begin{pmatrix}
1&0\\
0&1
\end{pmatrix}
\] では 2 本の列が独立なので、\(\operatorname{rank}(B)=2\) である。
\(A\in\mathbb R^{r\times k}\) なら \[
\operatorname{rank}(A)\le \min\{r,k\}
\] である。特に
- \(\operatorname{rank}(A)=k\) のとき、\(A\) は full column rank をもつという。
- \(\operatorname{rank}(A)=r\) のとき、\(A\) は full row rank をもつという。
full column rank は、\(A b=0\) を満たす \(b\) が \(b=0\) しかないことと同値である。つまり、列の間に完全な線形関係がない。
計量経済学では、ランク条件は「冗長な情報がない」「パラメタを識別できる」という意味で現れる。例えば、回帰の設計行列 \(X\in\mathbb R^{n\times k}\) が full column rank であることは、説明変数の間に完全な多重共線性がないことを意味する。このとき \[
X'X
\] は可逆であり、OLS の公式 \((X'X)^{-1}X'y\) が定義できる。
理由は次の通りである。任意の \(b\in\mathbb R^k\) について \[
b'X'Xb=(Xb)'(Xb)=\|Xb\|^2
\] である。\(X\) が full column rank なら、\(b\neq0\) なら \(Xb\neq0\) なので \[
b'X'Xb>0.
\] したがって \(X'X\) は正定値であり、可逆である。
GMM でも同じ発想が出てくる。モーメント条件のヤコビアン \[
G=\frac{\partial g(\theta_0)}{\partial\theta'}
\in\mathbb R^{K\times p}
\] が full column rank \(p\) をもつという仮定は、\(p\) 個のパラメタの局所的な変化が、モーメント条件に独立な方向として現れることを意味する。これは局所識別のための基本的なランク条件である。
仮説検定では full row rank が出てくる。例えば \(r\) 個の制約 \[
a(\theta_0)=0
\] を検定するとき、ヤコビアン \[
A(\theta_0)=\frac{\partial a(\theta_0)}{\partial\theta'}
\in\mathbb R^{r\times p}
\] が full row rank \(r\) をもつという仮定は、\(r\) 個の制約が互いに冗長ではないことを意味する。
逆行列
正方行列 \(A\in\mathbb R^{k\times k}\) に対して、 \[
A^{-1}A=AA^{-1}=I_k
\] を満たす行列 \(A^{-1}\) が存在するとき、\(A\) は可逆であるといい、\(A^{-1}\) を逆行列という。\(I_k\) は単位行列であり、対角成分が 1、それ以外が 0 の行列である。
2 次元の場合、 \[
A=
\begin{pmatrix}
a&b\\
c&d
\end{pmatrix}
\] について \(ad-bc\neq 0\) なら \[
A^{-1}
=
\frac{1}{ad-bc}
\begin{pmatrix}
d&-b\\
-c&a
\end{pmatrix}.
\]
公式を覚えるだけでなく、掃き出し法(行基本変形)で求める様子も見ておくとよい。例えば \[
A=
\begin{pmatrix}
2&1\\
1&1
\end{pmatrix}
\] の逆行列を求める。まず、左に \(A\)、右に単位行列を置いた拡大行列を作る。 \[
\left[
\begin{array}{cc|cc}
2&1&1&0\\
1&1&0&1
\end{array}
\right].
\] 目標は、左側を単位行列に変形することである。まず第 1 行と第 2 行を入れ替える。 \[
\left[
\begin{array}{cc|cc}
1&1&0&1\\
2&1&1&0
\end{array}
\right].
\] 次に、第 2 行から第 1 行の 2 倍を引く。 \[
R_2\leftarrow R_2-2R_1
\] とすると \[
\left[
\begin{array}{cc|cc}
1&1&0&1\\
0&-1&1&-2
\end{array}
\right]
\] となる。第 2 行に \(-1\) を掛けて、左下をきれいにする。 \[
R_2\leftarrow -R_2
\] より \[
\left[
\begin{array}{cc|cc}
1&1&0&1\\
0&1&-1&2
\end{array}
\right].
\] 最後に、第 1 行から第 2 行を引く。 \[
R_1\leftarrow R_1-R_2
\] すると \[
\left[
\begin{array}{cc|cc}
1&0&1&-1\\
0&1&-1&2
\end{array}
\right]
=
\left[
I\mid A^{-1}
\right]
\] が得られる。したがって \[
A^{-1}
=
\begin{pmatrix}
1&-1\\
-1&2
\end{pmatrix}.
\] 実際に掛け算して確認すると \[
\begin{pmatrix}
2&1\\
1&1
\end{pmatrix}
\begin{pmatrix}
1&-1\\
-1&2
\end{pmatrix}
=
\begin{pmatrix}
1&0\\
0&1
\end{pmatrix}
\] である。
一般の次元でも同じように、拡大行列 \[
[A\mid I]
\] を行基本変形で \[
[I\mid A^{-1}]
\] に変形することで逆行列を計算できる。実務では、明示的に逆行列を作るより、\(Ax=b\) を直接解く数値計算の方が安定である。
正方行列 \(A\in\mathbb R^{k\times k}\) が可逆であることは、 \[
\operatorname{rank}(A)=k
\] であることと同値である。ランクが落ちている行列は、どこかの方向の情報を失っているので、逆向きに一意に戻すことができない。
トレース
正方行列 \(A\) の トレース は対角成分の和であり、 \[
\operatorname{tr}(A)=\sum_i a_{ii}
\] と書く。トレースは、分散の合計やあとで見る射影行列の自由度を数えるときに出てくる。
よく使う性質は \[
\operatorname{tr}(AB)=\operatorname{tr}(BA)
\] である。ただし、積が定義されるサイズである必要がある。
固有値と固有ベクトル
正方行列 \(A\) に対して、0 でないベクトル \(v\) と数 \(\lambda\) が \[
Av=\lambda v
\] を満たすとき、\(\lambda\) を固有値、\(v\) を固有ベクトルという。これは、\(A\) を掛けても \(v\) の向きは変わらず、長さだけが \(\lambda\) 倍になるという意味である。
例えば \[
D=
\begin{pmatrix}
3&0\\
0&1
\end{pmatrix}
\] を考える。\(e_1=(1,0)'\) と \(e_2=(0,1)'\) について \[
De_1=
\begin{pmatrix}
3\\0
\end{pmatrix}
=3e_1,
\qquad
De_2=
\begin{pmatrix}
0\\1
\end{pmatrix}
=1e_2
\] である。したがって、\(e_1\) は固有値 3 の固有ベクトル、\(e_2\) は固有値 1 の固有ベクトルである。この行列は横方向を 3 倍し、縦方向はそのままにする。
もう少しだけ面白い例として \[
A=
\begin{pmatrix}
2&1\\
1&2
\end{pmatrix}
\] を考える。この行列は座標軸方向ではなく、斜め方向にわかりやすい伸び縮みをもつ。実際、 \[
A
\begin{pmatrix}
1\\1
\end{pmatrix}
=
\begin{pmatrix}
3\\3
\end{pmatrix}
=3
\begin{pmatrix}
1\\1
\end{pmatrix}
\] なので、\((1,1)'\) は固有値 3 の固有ベクトルである。また \[
A
\begin{pmatrix}
1\\-1
\end{pmatrix}
=
\begin{pmatrix}
1\\-1
\end{pmatrix}
=1
\begin{pmatrix}
1\\-1
\end{pmatrix}
\] なので、\((1,-1)'\) は固有値 1 の固有ベクトルである。つまり、この行列は \((1,1)'\) 方向を 3 倍し、\((1,-1)'\) 方向はそのままにする。
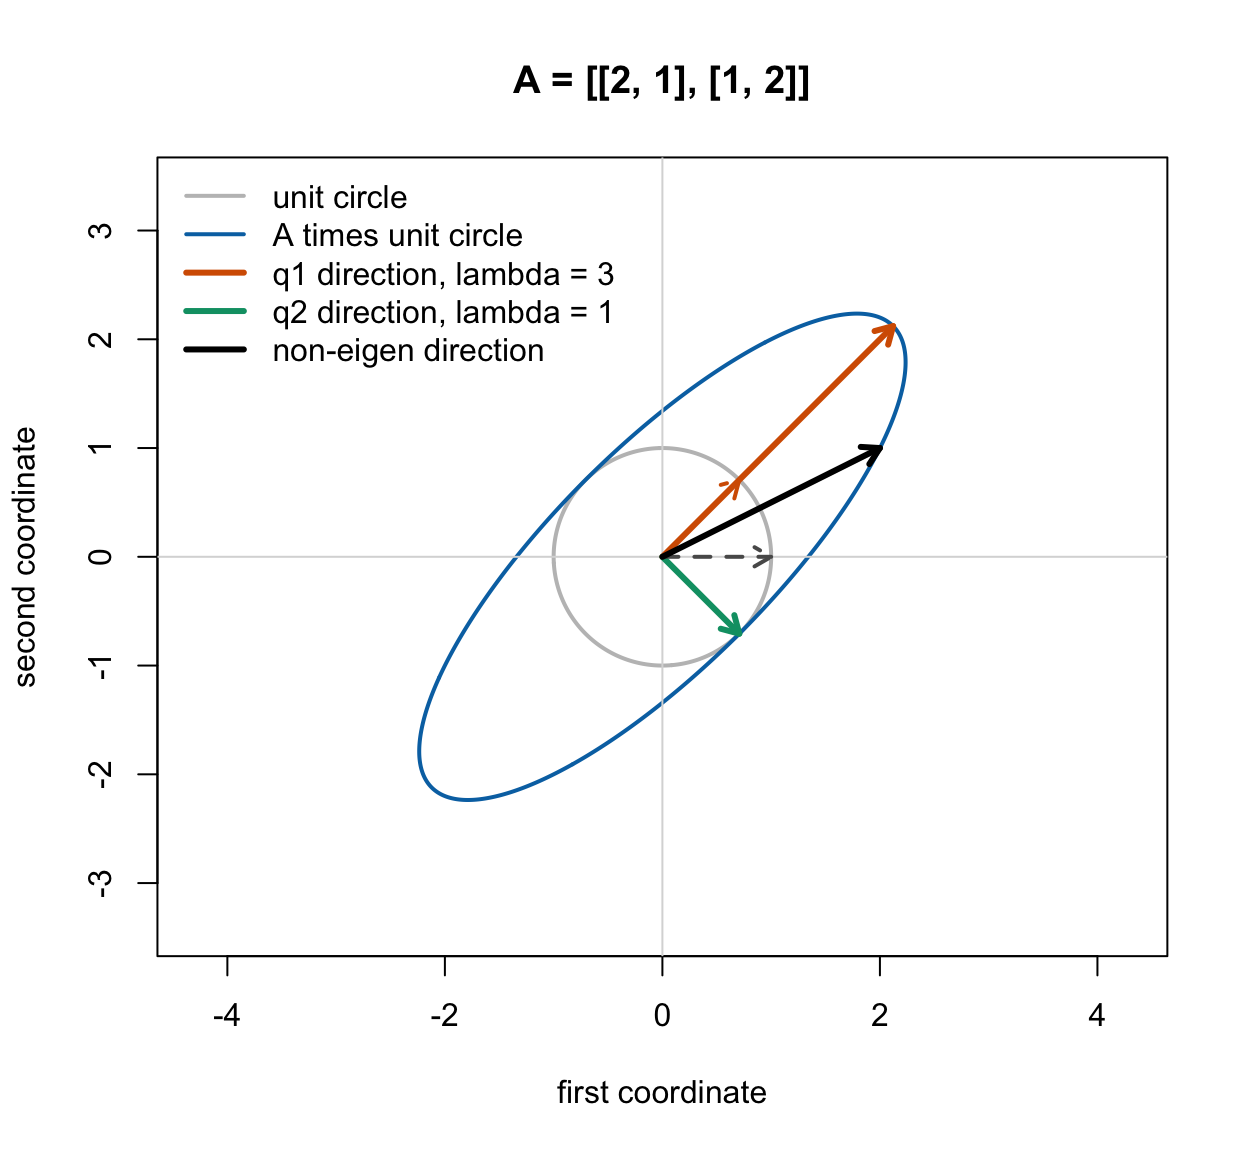
この様子は図で見るとわかりやすい。ここで「単位円に行列 \(A\) を掛ける」とは、円周上の各点を 2 次元ベクトルとして見て、そのすべてに同じ行列 \(A\) を掛けるという意味である。
単位円上の点は \[
x(t)=
\begin{pmatrix}
\cos t\\
\sin t
\end{pmatrix},
\qquad
0\le t\le 2\pi
\] と書ける。この各点を \[
y(t)=Ax(t)
\] に移す。つまり、円周上の点 \[
\begin{pmatrix}
x_1\\x_2
\end{pmatrix}
\] を \[
A
\begin{pmatrix}
x_1\\x_2
\end{pmatrix}
=
\begin{pmatrix}
2x_1+x_2\\
x_1+2x_2
\end{pmatrix}
\] へ写す。これを円周上のすべての点について行うと、円全体が別の曲線に変形される。この例では、単位円は楕円になる。
次の図では、薄い灰色の円がもとの単位円、青い楕円が行列 \(A\) を掛けた後の像である。破線の矢印は変換前のベクトル、太い実線の矢印は変換後のベクトルを表す。赤と緑の矢印は固有ベクトル方向である。固有ベクトル方向では、行列を掛けても同じ直線上に残り、長さだけが固有値倍になる。
A <- matrix(c(2, 1, 1, 2), nrow = 2, byrow = TRUE)

angle <- seq(0, 2 * pi, length.out = 500)
unit_circle <- rbind(cos(angle), sin(angle))
image_circle <- A %*% unit_circle

q1 <- c(1, 1) / sqrt(2)
q2 <- c(1, -1) / sqrt(2)
ordinary <- c(1, 0)

draw_arrow <- function(v, col, lty = 1, lwd = 2) {
  arrows(0, 0, v[1], v[2], col = col, lty = lty, lwd = lwd, length = 0.1)
}

plot(
  t(unit_circle),
  type = "l", asp = 1,
  xlim = c(-3.4, 3.4), ylim = c(-3.4, 3.4),
  xlab = "first coordinate", ylab = "second coordinate",
  col = "gray75", lwd = 2,
  main = "A = [[2, 1], [1, 2]]"
)
lines(t(image_circle), col = "#0072B2", lwd = 2)
abline(h = 0, v = 0, col = "gray85")

# Original eigenvector directions.
draw_arrow(q1, col = "#D55E00", lty = 2, lwd = 2)
draw_arrow(q2, col = "#009E73", lty = 2, lwd = 2)

# Transformed eigenvectors.
draw_arrow(A %*% q1, col = "#D55E00", lwd = 3)
draw_arrow(A %*% q2, col = "#009E73", lwd = 3)

# A non-eigenvector direction bends away from the original line.
draw_arrow(ordinary, col = "gray35", lty = 2, lwd = 2)
draw_arrow(A %*% ordinary, col = "black", lwd = 3)

legend(
  "topleft",
  legend = c(
    "unit circle",
    "A times unit circle",
    "q1 direction, lambda = 3",
    "q2 direction, lambda = 1",
    "non-eigen direction"
  ),
  col = c("gray75", "#0072B2", "#D55E00", "#009E73", "black"),
  lty = c(1, 1, 1, 1, 1),
  lwd = c(2, 2, 3, 3, 3),
  bty = "n"
)
破線の矢印は「変換前」の方向、太い実線の矢印は「変換後」の方向である。赤い固有方向 \(q_1=(1,1)'/\sqrt2\) は同じ方向のまま 3 倍に伸びる。緑の固有方向 \(q_2=(1,-1)'/\sqrt2\) は同じ方向のまま長さが変わらない。一方、黒い矢印で示した普通の方向 \((1,0)'\) は、\(A(1,0)'=(2,1)'\) となり、もとの方向から傾く。固有ベクトルとは、このような「傾かない特別な方向」のことである。
では、なぜこの「傾かない方向」を見つけるとうれしいのか。理由は、行列の働きを一番わかりやすい方向に分解できるからである。一般の方向にあるベクトルは、行列を掛けると向きも長さも同時に変わるので解釈しにくい。しかし固有ベクトル方向では、起きることは単純である。 \[
\text{固有ベクトル方向では、行列は「}\lambda\text{ 倍するだけ」である。}
\] したがって、行列 \(A\) がどの方向を強く伸ばし、どの方向をあまり伸ばさないのかを、固有値と固有ベクトルで読むことができる。
計量経済学では、この見方が何度も出てくる。分散共分散行列の固有ベクトルは「データのばらつきが大きい方向」を表し、固有値はその方向の分散の大きさを表す。Hessian の固有ベクトルは目的関数の曲率の方向を表し、固有値はその方向にどれくらい急に曲がっているかを表す。GMM の重み行列や漸近分散行列を考えるときも、行列を「方向ごとの伸び縮み」として理解できると、どの方向で推定が精密か、どの方向で不安定かが見えやすくなる。
固有値の計算方法
固有値は \[
Av=\lambda v
\] を \[
(A-\lambda I)v=0
\] と書き換えて求める。\(v\neq0\) の解が存在するためには、行列 \(A-\lambda I\) がランク落ちしている必要がある。したがって \[
\det(A-\lambda I)=0
\] を解けば固有値が得られる。
上の例 \[
A=
\begin{pmatrix}
2&1\\
1&2
\end{pmatrix}
\] では \[
A-\lambda I
=
\begin{pmatrix}
2-\lambda&1\\
1&2-\lambda
\end{pmatrix}
\] だから \[
\det(A-\lambda I)
=(2-\lambda)^2-1
=\lambda^2-4\lambda+3
=(\lambda-3)(\lambda-1).
\] したがって固有値は \[
\lambda=3,\quad 1
\] である。
固有ベクトルは、それぞれの固有値を代入して \[
(A-\lambda I)v=0
\] を解けばよい。例えば \(\lambda=3\) なら \[
A-3I=
\begin{pmatrix}
-1&1\\
1&-1
\end{pmatrix}
\] なので \[
-v_1+v_2=0
\] より \(v_1=v_2\) である。したがって固有ベクトルは \((1,1)'\) の定数倍である。\(\lambda=1\) なら \[
A-I=
\begin{pmatrix}
1&1\\
1&1
\end{pmatrix}
\] なので \[
v_1+v_2=0
\] より、固有ベクトルは \((1,-1)'\) の定数倍である。
一般の \(k\times k\) 行列でも考え方は同じである。
- \(\det(A-\lambda I)=0\) を解いて固有値を求める。
- 各固有値 \(\lambda\) について \((A-\lambda I)v=0\) を解いて固有ベクトルを求める。
ただし、次元が大きい行列では手計算で行列式を展開するのは現実的ではない。実務では、数値計算で固有値分解を行う。
対称行列では固有値は実数になり、異なる固有値に対応する固有ベクトルは直交する。したがって、対称行列は互いに直交する方向ごとの伸び縮みとして理解できる。計量経済学では、分散共分散行列、Hessian、GMM の重み行列などを理解するためにこの見方が重要である。
特に対称行列 \(A\) について、固有値を \(\lambda_1,\ldots,\lambda_k\)、対応する正規直交固有ベクトルを \(q_1,\ldots,q_k\) と書くと、 \[
A=Q\Lambda Q',
\qquad
Q=(q_1,\ldots,q_k),
\qquad
\Lambda=\operatorname{diag}(\lambda_1,\ldots,\lambda_k)
\] と分解できる。このとき任意の \(z\) について \[
z'Az
=
(Q'z)'\Lambda(Q'z)
=
\sum_{j=1}^k \lambda_j c_j^2,
\qquad
c=Q'z
\] である。したがって、すべての固有値が正なら \(z'Az>0\)、すべての固有値が 0 以上なら \(z'Az\ge0\) になる。この事実が、次に見る正定値・半正定値の判定につながる。
多変量正規分布と分散共分散行列
正定値行列の話に進む前に、分散共分散行列が何を表しているかを整理しておく。
1 変量の正規分布は \[
X\sim N(\mu,\sigma^2)
\] と書く。ここで \(\mu\) は平均、\(\sigma^2\) は分散である。多変量の場合、確率ベクトル \[
X=
\begin{pmatrix}
X_1\\
\vdots\\
X_k
\end{pmatrix}
\] が多変量正規分布に従うことを \[
X\sim N(\mu,\Sigma)
\] と書く。ここで \[
\mu=
\begin{pmatrix}
E[X_1]\\
\vdots\\
E[X_k]
\end{pmatrix}
\] は平均ベクトルであり、 \[
\Sigma
=
\operatorname{Var}(X)
=
E[(X-\mu)(X-\mu)']
\] は分散共分散行列である。
2 変量なら \[
\Sigma=
\begin{pmatrix}
\operatorname{Var}(X_1)&\operatorname{Cov}(X_1,X_2)\\
\operatorname{Cov}(X_2,X_1)&\operatorname{Var}(X_2)
\end{pmatrix}
\] である。対角成分は各変数の分散であり、非対角成分は変数間の共分散である。共分散が正なら、\(X_1\) が大きいとき \(X_2\) も大きくなりやすい。共分散が負なら、\(X_1\) が大きいとき \(X_2\) は小さくなりやすい。
\(\Sigma\) が正定値のとき、多変量正規分布の密度は \[
f(x)
=
\frac{1}{(2\pi)^{k/2}|\Sigma|^{1/2}}
\exp\left\{
-\frac12(x-\mu)'\Sigma^{-1}(x-\mu)
\right\}
\] である。ここで \[
(x-\mu)'\Sigma^{-1}(x-\mu)
\] は、分散共分散行列で調整した距離である。\(\Sigma\) が大きい方向では、同じだけ動いても「それほど珍しくない」と判断される。
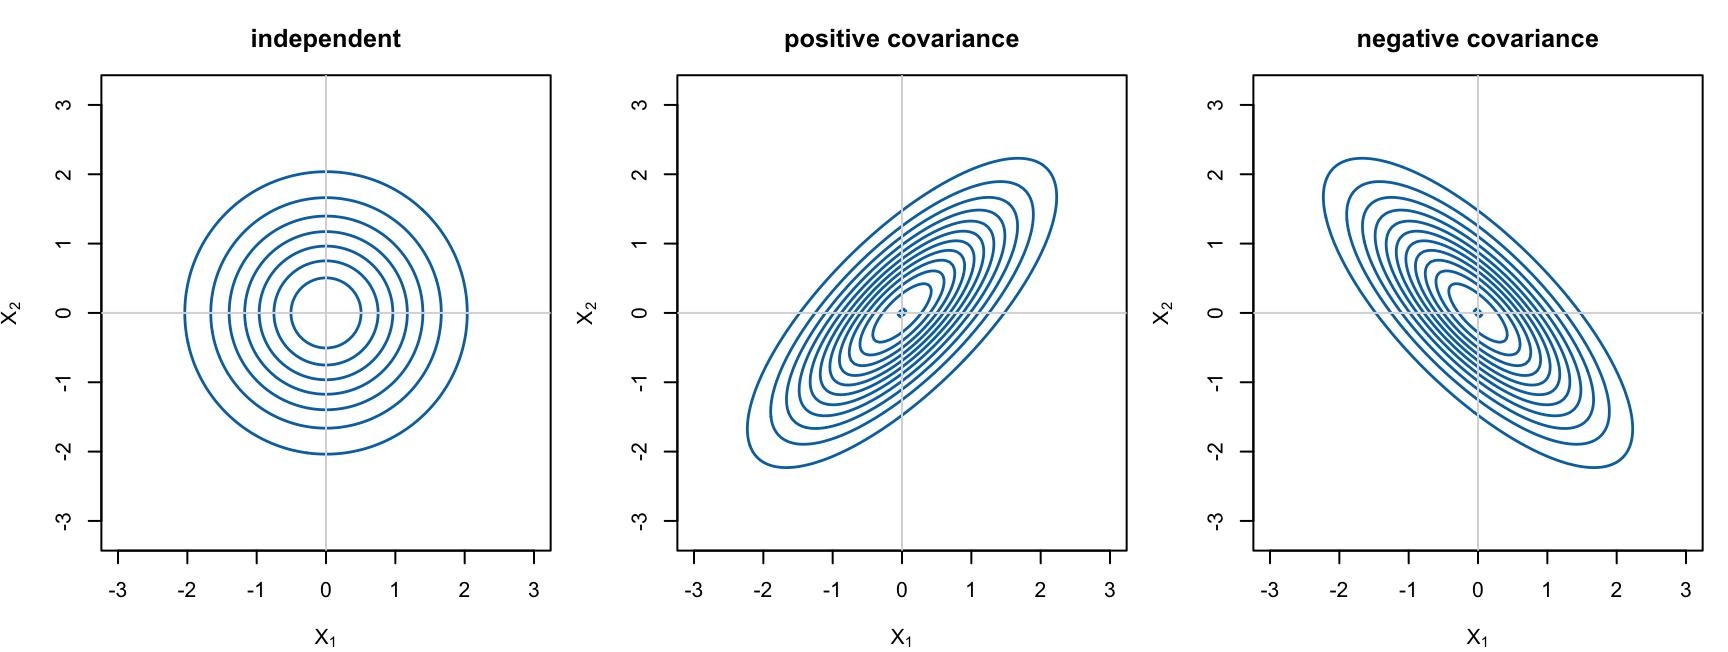
次の図では、平均 0 の 2 変量正規分布について、分散共分散行列を変えたときに等高線がどう変わるかを描いている。
dmvnorm2 <- function(x1, x2, Sigma) {
  X <- cbind(as.vector(x1), as.vector(x2))
  inv_Sigma <- solve(Sigma)
  quad <- rowSums((X %*% inv_Sigma) * X)
  dens <- exp(-0.5 * quad) / (2 * pi * sqrt(det(Sigma)))
  matrix(dens, nrow = nrow(x1), ncol = ncol(x1))
}

grid <- seq(-3, 3, length.out = 120)
grid_xy <- expand.grid(x = grid, y = grid)
x_mat <- matrix(grid_xy$x, nrow = length(grid), ncol = length(grid))
y_mat <- matrix(grid_xy$y, nrow = length(grid), ncol = length(grid))

Sigmas <- list(
  "independent" = matrix(c(1, 0, 0, 1), 2, 2),
  "positive covariance" = matrix(c(1, 0.75, 0.75, 1), 2, 2),
  "negative covariance" = matrix(c(1, -0.75, -0.75, 1), 2, 2)
)

old_par <- par(mfrow = c(1, 3), mar = c(4, 4, 3, 1))

for (name in names(Sigmas)) {
  z <- dmvnorm2(x_mat, y_mat, Sigmas[[name]])
  contour(
    grid, grid, z,
    xlab = expression(X[1]), ylab = expression(X[2]),
    main = name,
    asp = 1,
    drawlabels = FALSE,
    col = "#0072B2",
    lwd = 1.4
  )
  abline(h = 0, v = 0, col = "gray85")
}

par(old_par)
独立な場合、等高線は軸に沿った円になる。正の共分散があると、等高線は右上がりに傾く。負の共分散があると、等高線は右下がりに傾く。したがって分散共分散行列は、「各変数がどれくらいばらつくか」だけでなく、「どの方向に一緒に動きやすいか」を表している。
この行列が半正定値でなければならない理由も自然である。任意のベクトル \(z\) について、線形結合 \(z'X\) の分散は \[
\operatorname{Var}(z'X)
=
z'\Sigma z
\] である。分散は負になれないので、必ず \[
z'\Sigma z\ge0
\] でなければならない。この性質が、次の半正定値・正定値の定義につながる。
半正定値行列と正定値行列
対称行列 \(A\) が 半正定値 であるとは、任意のベクトル \(z\) について \[
z'Az\ge0
\] が成り立つことである。このとき \[
A\succeq0
\] と書くことがある。
対称行列 \(A\) が 正定値 であるとは、任意の 0 でないベクトル \(z\) について \[
z'Az>0
\] が成り立つことである。
正定値行列は、2 次関数 \[
z'Az
\] が原点以外で必ず正になることを意味する。対称行列の場合、正定値であることは、すべての固有値が正であることと同値である。半正定値であることは、すべての固有値が 0 以上であることと同値である。
分散共分散行列は必ず半正定値である。確率ベクトル \(V\) の分散共分散行列を \[
\Omega=\operatorname{Var}(V)
\] とすると、任意の \(z\) について \[
z'\Omega z
=
\operatorname{Var}(z'V)
\ge0
\] だからである。もし \(z'V\) の分散が 0 になるような非ゼロの \(z\) が存在しなければ、\(\Omega\) は正定値である。
正定値行列は可逆であり、極値推定では目的関数の曲率や GMM の重み行列としてよく現れる。一方、半正定値行列は可逆とは限らない。例えば、分散共分散行列が特異である場合、データやモーメントの中に完全な線形関係があることを示している。
また、2 つの対称行列 \(A\) と \(B\) について \[
A\succeq B
\] と書くときは、 \[
A-B
\] が半正定値であるという意味である。GMM の効率性を比較するときに、この半正定値の意味での大小関係を使う。
ベクトルについての微分
パラメタ \(\theta=(\theta_1,\ldots,\theta_p)'\) に依存するスカラー関数 \(q(\theta)\) の勾配は \[
\frac{\partial q(\theta)}{\partial\theta}
=
\begin{pmatrix}
\partial q(\theta)/\partial\theta_1\\
\vdots\\
\partial q(\theta)/\partial\theta_p
\end{pmatrix}.
\]
2 階微分を並べた行列を Hessian という。 \[
\frac{\partial^2 q(\theta)}{\partial\theta\partial\theta'}
=
\left(
\frac{\partial^2 q(\theta)}{\partial\theta_i\partial\theta_j}
\right)_{i,j}.
\]
よく使う公式は次の通りである。\(a\) はベクトル、\(A\) は対称行列とする。 \[
\frac{\partial a'\theta}{\partial\theta}=a,
\qquad
\frac{\partial}{\partial\theta}\left(\frac12\theta'A\theta\right)=A\theta.
\]
また、\(b-A\theta\) という残差ベクトルに対して \[
\frac{\partial}{\partial\theta}(b-A\theta)'(b-A\theta)
=
-2A'(b-A\theta).
\]
ベクトル値関数 \(g(\theta)\in\mathbb R^K\) の微分はヤコビアンで表す。 \[
G(\theta)
=
\frac{\partial g(\theta)}{\partial\theta'}
\in\mathbb R^{K\times p}.
\]
応用:OLS の行列表記
観測を縦に積んで \[
y=
\begin{pmatrix}
y_1\\
\vdots\\
y_n
\end{pmatrix},
\qquad
X=
\begin{pmatrix}
x_1'\\
\vdots\\
x_n'
\end{pmatrix},
\qquad
\beta=
\begin{pmatrix}
\beta_1\\
\vdots\\
\beta_k
\end{pmatrix}
\] と書く。線形回帰モデルは \[
y=X\beta_0+u
\] である。
OLS は残差平方和 \[
S(\beta)=(y-X\beta)'(y-X\beta)
\] を最小化する。微分公式を使うと \[
\frac{\partial S(\beta)}{\partial\beta}
=
-2X'(y-X\beta).
\]
一階条件は \[
X'(y-X\hat\beta)=0
\] である。これを整理すると正規方程式 \[
X'X\hat\beta=X'y
\] が得られる。\(X'X\) が可逆なら \[
\hat\beta=(X'X)^{-1}X'y
\] である。
この式は、OLS 推定量が「残差をすべての説明変数と直交させる」ように選ばれていることを意味する。さらに \(y=X\beta_0+u\) を代入すると \[
\hat\beta-\beta_0=(X'X)^{-1}X'u
=
\left(\frac{X'X}{n}\right)^{-1}\left(\frac{X'u}{n}\right)
\] となる。両辺に \(\sqrt n\) を掛けると \[
\sqrt n(\hat\beta-\beta_0)
=
\left(\frac{X'X}{n}\right)^{-1}
\left(\frac{X'u}{\sqrt n}\right),
\] となる。この形は、OLS の一致性を考えるときに、標本平均 \[
\frac{X'X}{n},
\qquad
\frac{X'u}{n}
\] がそれぞれ母集団の対応物に近づくことを示せばよい、という見通しを与える。
応用:OLS と射影行列
OLS は、幾何学的には \(y\) を \(X\) の列空間に射影する操作である。この見方を行列で表すと、回帰分析の多くの性質が短く書ける。
正方行列 \(P\) が \[
P^2=P
\] を満たすとき、\(P\) を 冪等行列 という。さらに \[
P'=P
\] も満たすとき、\(P\) は直交射影行列である。
\(X\) が full column rank のとき、 \[
P_X=X(X'X)^{-1}X'
\] は \(X\) の列空間への直交射影行列である。実際、OLS の fitted value は \[
\hat y
=
X\hat\beta
=
X(X'X)^{-1}X'y
=
P_Xy
\] と書ける。つまり、\(\hat y\) は \(y\) を説明変数の張る空間に落としたものである。
残差を作る行列は \[
M_X=I-P_X
\] である。OLS の残差は \[
\hat u
=
y-\hat y
=
(I-P_X)y
=
M_Xy
\] と書ける。
射影行列は次の性質をもつ。 \[
P_X^2=P_X,
\qquad
P_X'=P_X,
\qquad
M_X^2=M_X,
\qquad
M_X'=M_X.
\] また \[
X'M_X=0
\] である。これは、OLS 残差がすべての説明変数と直交することを行列で書いたものである。実際、 \[
X'\hat u
=
X'M_Xy
=0
\] であり、これは正規方程式 \(X'(y-X\hat\beta)=0\) と同じ内容である。
射影行列のランクは、射影先の空間の次元を表す。\(X\) が \(n\times k\) で full column rank なら \[
\operatorname{rank}(P_X)=k,
\qquad
\operatorname{rank}(M_X)=n-k.
\] この \(n-k\) は OLS の残差自由度として現れる。冪等行列では、トレースとランクが一致するので \[
\operatorname{tr}(P_X)=k,
\qquad
\operatorname{tr}(M_X)=n-k
\] でもある。
導入
推定とは、データを見て未知のパラメタ \(\theta_0\) を当てにいく作業である。極値推定では、この作業を次の形で書く。
まず、観測データ \[
X_1,\ldots,X_n
\] から、各パラメタ値 \(\theta\in\Theta\) に点数をつける関数 \[
Q_n:\Theta\to\mathbb R
\] を作る。この \(Q_n(\theta)\) を 標本目的関数 という。\(Q_n(\theta)\) はデータから作られるので、固定された \(\theta\) に対しても確率変数である。つまり、標本が変われば \(Q_n\) の形も変わる。
そのうえで、 \[
\hat\theta
\in
\operatorname*{arg\,max}_{\theta\in\Theta} Q_n(\theta)
\] となるような \(\theta\) を推定量として選ぶ。最小化問題も符号を反転させれば最大化問題として書けるので、本章では最大化に統一する。例えば二乗残差和を最小化する OLS は、負の二乗残差和を最大化する推定量として書ける。
標本サイズが大きくなると、\(Q_n(\theta)\) は多くの場合、ある非ランダムな関数 \[
Q:\Theta\to\mathbb R
\] に近づく。この \(Q(\theta)\) を 母目的関数 という。直観的には、 \[
Q_n(\theta)\approx Q(\theta)
\] であり、もし \(Q(\theta)\) が真の値 \(\theta_0\) で一意に最大化されるなら、\(Q_n(\theta)\) を最大化する \(\hat\theta\) も \(\theta_0\) の近くに来るはずである。
ただし、ここで大事なのは、\(Q_n(\theta)\) が各固定された \(\theta\) で \(Q(\theta)\) に近づくだけでは足りない、という点である。推定量 \(\hat\theta\) 自体が \(Q_n\) を見て動くので、\(\theta\) 全体でまとめて \[
\sup_{\theta\in\Theta}|Q_n(\theta)-Q(\theta)|
\] が小さくなる必要がある。これが後で見る uniform convergence である。
定義 1 (極値推定量) \(\hat\theta\) を \(\Theta\) 値の可測関数とする。\(\hat\theta\) が \[
Q_n(\hat\theta) \geq \sup_{\theta\in\Theta} Q_n(\theta)-\eta_n,
\tag{1}\] を満たし、かつ \(\eta_n=o_p(1)\) であるとき、\(\hat\theta\) を 極値推定量 と呼ぶ。
式 式 1 の \(\eta_n\) は、数値最適化の誤差を許すための項である。実際の応用では、特にシミュレーションを含む推定法では目的関数を厳密に最大化することは難しい。そのため、
- 理論上の最大値に十分近い値を達成していればよい
- その誤差が漸近的に無視できればよい
という立場をとる。
母目的関数 \(Q: \Theta \to \mathbb{R}\) は、標本目的関数の確率極限に対応する。真のパラメタ \(\theta_0\) は、通常 \[
Q(\theta_0) \geq Q(\theta) \qquad (\forall\theta\in\Theta)
\] を満たす点として定義される。さらに \[
Q(\theta_0)>Q(\theta) \qquad (\forall\theta\neq \theta_0)
\] が成り立つとき、\(\theta_0\) は識別されているという。
極値推定の基本発想は単純である。
- 有限標本では \(Q_n\) を最大化して \(\hat\theta\) を得る。
- 標本が大きくなると \(Q_n\) は \(Q\) に近づく。
- したがって、\(Q_n\) の最大化点は \(Q\) の最大化点 \(\theta_0\) に近づくはずである。
本章の一致性理論は、この素朴な直観を厳密にしたものである。
極値推定の代表例
この章では後続章で詳しく扱う M 推定と GMM を、極値推定という観点からまとめておく。
M 推定
M 推定の \(M\) は、Huber の用語で maximum likelihood type の \(M\) である。最尤法そのものに限らず、最尤法のように「標本平均の形をした目的関数を最大化する」推定法をまとめて呼ぶための名前である。GMM の moments の \(M\) とは別物なので、ここは少し注意しておきたい。
M 推定では標本目的関数が \[
Q_n(\theta)=\frac{1}{n}\sum_{t=1}^n m(X_t;\theta)
\] という標本平均の形をとる。したがって、独立同分布データのもとでは \[
Q_n(\theta) \to_p E[m(X_t;\theta)] \equiv Q(\theta)
\] が各固定された \(\theta\) について成り立つ。
代表例は次の通りである。
最尤法
\(m(X_t;\theta)=\log f(X_t;\theta)\) とおけば、最尤法は M 推定量になる。
マルコフ過程の条件付き最尤法
\(X_t=(Y_t,Y_{t-1})\) として \[
m(X_t;\theta)=\log f(Y_t\mid Y_{t-1};\theta)
\] と置けばよい。
非線形最小二乗法
条件付き平均が \(E[Y_t\mid Z_t]=\varphi(Z_t;\theta_0)\) であれば \[
Q_n(\theta)=-\frac1n\sum_{t=1}^n\bigl(Y_t-\varphi(Z_t;\theta)\bigr)^2
\] を最大化することで推定できる。
線形回帰 \[
Y_t=x_t'\beta_0+u_t
\] を考える。ここで \(x_t\) は定数項を含む説明変数ベクトルだとする。OLS は残差二乗和を最小化する推定量だが、符号を反転させれば \[
Q_n(\beta)
=-\frac{1}{2n}\sum_{t=1}^n (Y_t-x_t'\beta)^2
\] を最大化する推定量である。これは \[
m(X_t;\beta)=-\frac12(Y_t-x_t'\beta)^2
\] と置いた M 推定そのものである。
母目的関数は \[
Q(\beta)
=-\frac12 E[(Y_t-x_t'\beta)^2]
\] である。\(Y_t=x_t'\beta_0+u_t\) を代入すると \[
Y_t-x_t'\beta
=u_t-x_t'(\beta-\beta_0)
\] だから、 \[
Q(\beta)-Q(\beta_0)
=
-\frac12(\beta-\beta_0)'E[x_tx_t'](\beta-\beta_0)
+E[u_tx_t'](\beta-\beta_0).
\] もし \[
E[x_tu_t]=0,
\qquad
E[x_tx_t'] \text{ が正定値}
\] なら、第 2 項は 0 であり、\(\beta\neq\beta_0\) では第 1 項が負になる。したがって \(Q(\beta)\) は \(\beta_0\) で一意に最大化される。つまり、OLS の一致性は「標本の二乗誤差目的関数が、母集団の二乗誤差目的関数に一様に近づく」という極値推定の話として理解できる。
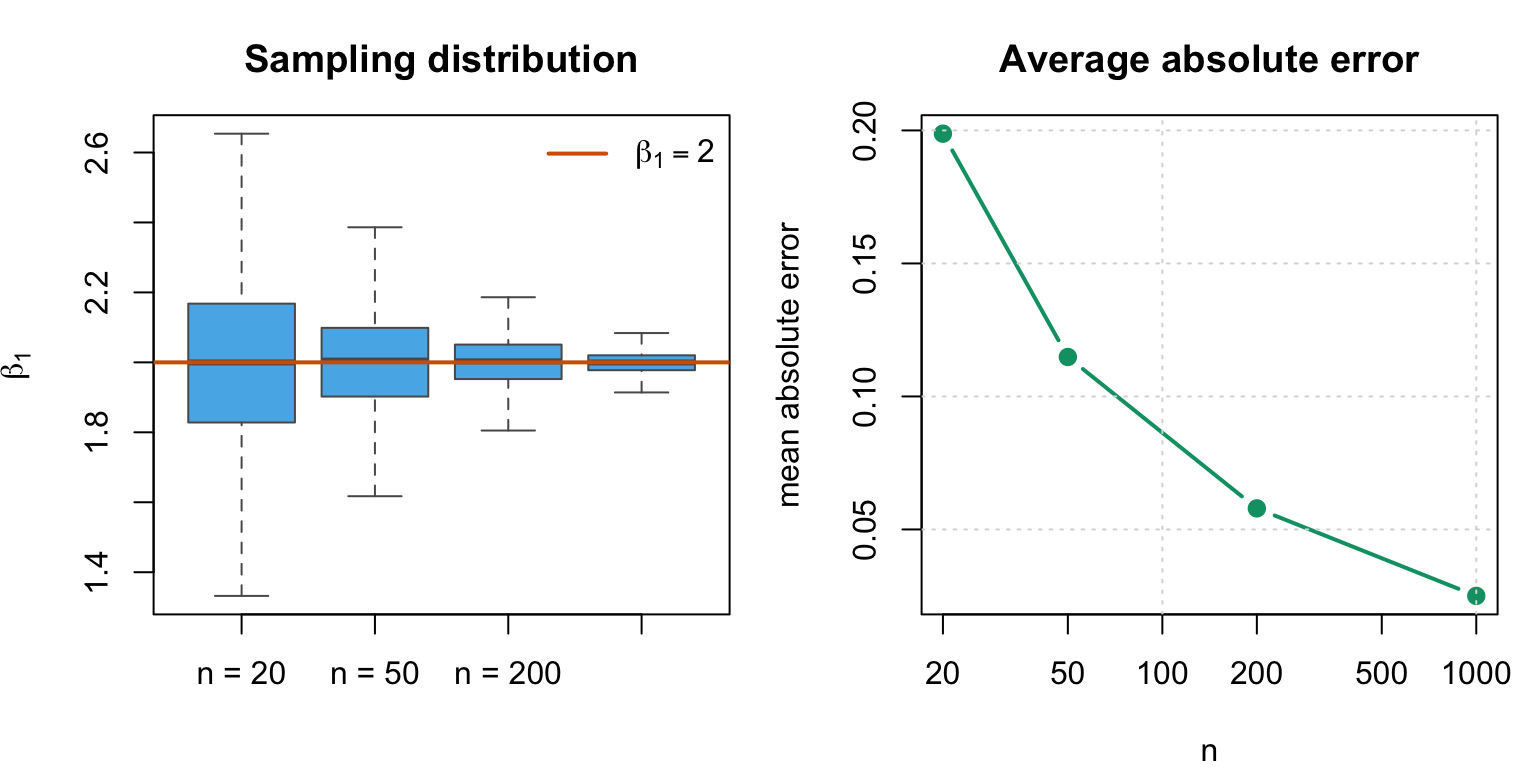
次のシミュレーションでは、 \[
Y_t=1+2X_t+u_t,
\qquad
X_t\sim N(0,1),
\qquad
u_t\sim N(0,1)
\] を繰り返し発生させ、各標本サイズで OLS の傾き推定値を計算している。ここで見たいのは漸近正規性ではなく、標本サイズが大きくなるほど推定値が真の値 \(2\) の近くに集まる、という一致性の感覚である。
set.seed(123)

beta0 <- 1
beta1 <- 2
sigma_u <- 1
n_values <- c(20, 50, 200, 1000)
B <- 1000

ols_slope_once <- function(n) {
  x <- rnorm(n)
  u <- rnorm(n, sd = sigma_u)
  y <- beta0 + beta1 * x + u
  unname(coef(lm(y ~ x))[2])
}

slope_draws <- lapply(n_values, function(n) {
  replicate(B, ols_slope_once(n))
})
names(slope_draws) <- paste0("n = ", n_values)

mean_absolute_error <- sapply(slope_draws, function(v) {
  mean(abs(v - beta1))
})

old_par <- par(mfrow = c(1, 2), mar = c(4, 4, 3, 1))

boxplot(
  slope_draws,
  outline = FALSE,
  col = "#56B4E9",
  border = "gray35",
  ylab = expression(hat(beta)[1]),
  main = "Sampling distribution"
)
abline(h = beta1, col = "#D55E00", lwd = 2)
legend(
  "topright",
  legend = expression(beta[1] == 2),
  col = "#D55E00",
  lty = 1,
  lwd = 2,
  bty = "n"
)

plot(
  n_values,
  mean_absolute_error,
  type = "b",
  pch = 19,
  lwd = 2,
  log = "x",
  col = "#009E73",
  xlab = "n",
  ylab = "mean absolute error",
  main = "Average absolute error"
)
grid(col = "gray85")

par(old_par)
GMM
GMM ではモーメント条件 \[
E[g(X_t;\theta_0)]=0
\] を用いる。標本モーメントを \[
g_n(\theta)=\frac1n\sum_{t=1}^n g(X_t;\theta)
\] とすると、標本目的関数は \[
Q_n(\theta)=-\frac12 g_n(\theta)'\widehat W_n g_n(\theta)
\] で与えられる。ここで \(\widehat W_n\) は正定値対称な重み行列である。母目的関数は \[
Q(\theta)=-\frac12 g(\theta)'Wg(\theta),
\qquad g(\theta)=E[g(X_t;\theta)]
\] となる。
同じ OLS を、GMM の一例としても見ることができる。線形回帰で外生性条件 \[
E[x_tu_t]=0,
\qquad
u_t=Y_t-x_t'\beta_0
\] が成り立つなら、 \[
E[x_t(Y_t-x_t'\beta_0)]=0
\] である。そこで \[
g(X_t;\beta)=x_t(Y_t-x_t'\beta)
\] と置けば、標本モーメントは \[
g_n(\beta)=\frac1n\sum_{t=1}^n x_t(Y_t-x_t'\beta)
\] になる。
もしモーメントの数とパラメタの数が同じ、つまり \(x_t\) の次元が \(\beta\) の次元と同じなら、この GMM は just identified である。この場合、GMM 推定量は基本的に \[
g_n(\hat\beta)=0
\] を解く推定量になる。これは \[
\frac1n\sum_{t=1}^n x_t(Y_t-x_t'\hat\beta)=0
\] であり、行列表記では \[
X'(Y-X\hat\beta)=0
\] である。したがって \[
\hat\beta=(X'X)^{-1}X'Y
\] が得られる。これは通常の OLS 推定量である。
つまり OLS は、
- 二乗誤差を最小化する M 推定量
- 正規方程式というモーメント条件を合わせる GMM 推定量
の両方として理解できる。同じ推定量でも、目的関数から見るか、モーメント条件から見るかで、M 推定と GMM という 2 つの顔をもつ。
M 推定の score をモーメント条件として見る
OLS の例で見たことは、もっと一般に成り立つ。滑らかな M 推定量を \[
\hat\theta
=
\operatorname*{arg\,max}_{\theta\in\Theta}
Q_n(\theta),
\qquad
Q_n(\theta)=\frac1n\sum_{t=1}^n m(X_t;\theta)
\] と書く。
もし最大化点 \(\hat\theta\) がパラメタ空間の内部にあり、目的関数が \(\theta\) について微分可能なら、厳密な最大化点では一階条件 \[
0
=
\frac{\partial Q_n(\hat\theta)}{\partial\theta}
=
\frac1n\sum_{t=1}^n
\frac{\partial m(X_t;\hat\theta)}{\partial\theta}
\] が成り立つ。
ここで \[
s(X_t;\theta)
=
\frac{\partial m(X_t;\theta)}{\partial\theta}
\] とおく。この \(s(X_t;\theta)\) は、目的関数の勾配であり、最尤法では score と呼ばれる。すると M 推定量の一階条件は \[
\frac1n\sum_{t=1}^n s(X_t;\hat\theta)=0
\] と書ける。
これは \[
E[s(X_t;\theta_0)]=0
\] というモーメント条件の標本版である。したがって、滑らかな M 推定量は、少なくとも一階条件のレベルでは \[
g(X_t;\theta)=s(X_t;\theta)
\] を使った GMM のように見ることができる。OLS の正規方程式 \[
\frac1n\sum_{t=1}^n x_t(Y_t-x_t'\hat\beta)=0
\] は、この一般的な score moment の具体例である。
この見方は便利だが、一階条件はあくまで「局所的な山の頂上候補」を表す条件である。一階条件を満たす点が、大域的な最大化点であるとは限らない。極値推定の一致性で clean maximum と uniform convergence を使うのは、標本目的関数の最大化点が母目的関数の正しい山に近づくことを保証するためである。
weighting matrix が有益な理由
GMM の目的関数は \[
Q_n(\theta)
=-\frac12 g_n(\theta)'\widehat W_n g_n(\theta)
\] である。ここで \(\widehat W_n\) は、複数のモーメント条件のズレをどの尺度で測るかを決める行列である。
まず、もっとも単純な場合を考える。モーメント条件が 1 つだけなら、 \[
Q_n(\theta)=-\frac12 W_n g_n(\theta)^2
\] である。\(W_n>0\) は単なる正の定数なので、\(Q_n(\theta)\) を最大化する \(\theta\) は、\(g_n(\theta)^2\) を最小にする \(\theta\) と同じである。つまり、モーメントが 1 つだけなら、重みは推定量を本質的には変えない。
しかし、モーメント条件が複数あると話が変わる。標本では、すべてのモーメントを同時に 0 にできるとは限らない。例えば \[
g_n(\theta)
=
\begin{pmatrix}
g_{1n}(\theta)\\
g_{2n}(\theta)
\end{pmatrix}
\] があり、ある \(\theta\) では \(g_{1n}(\theta)\) は小さいが \(g_{2n}(\theta)\) は大きい、別の \(\theta\) ではその逆、ということが起きる。このとき、GMM は \[
g_n(\theta)'\widehat W_n g_n(\theta)
\] を小さくする \(\theta\) を選ぶ。したがって \(\widehat W_n\) は、「どのモーメントのズレをどれくらい重く見るか」を決めている。
just identified、つまりモーメント条件の数とパラメタの数が同じ場合には、理想的には \[
g_n(\hat\theta)=0
\] を解けばよい。この場合、どの正定値な重み行列を使っても、一階の漸近分散は変わらない。OLS を GMM として見たときに weighting matrix が表に出てこないのは、このためである。
一方、over identified、つまりモーメント条件がパラメタより多い場合には、有限標本ではすべてのモーメントを同時に 0 にできないことが多い。そこで、どのモーメントのズレをより重く見るかが問題になる。このとき weighting matrix が効いてくる。
具体例:精度の違う 2 つのモーメント
1 つのスカラー・パラメタ \(\theta_0\) を推定したいとする。観測データから、\(\theta_0\) について 2 つの情報が得られるとしよう。 \[
A_t=\theta_0+\varepsilon_{1t},
\qquad
B_t=\theta_0+\varepsilon_{2t}.
\] どちらも平均的には \(\theta_0\) を測っているが、精度が違うとする。 \[
E[\varepsilon_{1t}]=E[\varepsilon_{2t}]=0,
\qquad
\operatorname{Var}(\varepsilon_{1t})=1,
\qquad
\operatorname{Var}(\varepsilon_{2t})=9.
\] \(B_t\) の方が、\(A_t\) より 9 倍ノイズが大きい。
このとき、自然なモーメント条件は \[
E[A_t-\theta_0]=0,
\qquad
E[B_t-\theta_0]=0
\] である。標本モーメントは \[
g_n(\theta)
=
\begin{pmatrix}
\bar A-\theta\\
\bar B-\theta
\end{pmatrix}
\] となる。
もし重み行列を単位行列 \(W=I\) にすると、GMM は \[
(\bar A-\theta)^2+(\bar B-\theta)^2
\] を最小化する。これは \(\bar A\) と \(\bar B\) を同じ重さで平均するので、 \[
\hat\theta_I=\frac{\bar A+\bar B}{2}
\] になる。しかしこれは少しもったいない。なぜなら、\(\bar B\) は \(\bar A\) よりかなり noisy なのに、同じだけ信じてしまっているからである。
実際、この推定量の分散は \[
\operatorname{Var}(\hat\theta_I)
=
\frac14\operatorname{Var}(\bar A)
+\frac14\operatorname{Var}(\bar B)
=
\frac14\cdot\frac1n+\frac14\cdot\frac9n
=
\frac{2.5}{n}
\] である。
では、より自然にはどうすればよいか。ノイズの小さい \(\bar A\) を強く信じ、ノイズの大きい \(\bar B\) は弱く信じればよい。ここではモーメントの分散共分散行列は \[
S
=
\operatorname{Var}\!\left(\sqrt n\,g_n(\theta_0)\right)
=
\begin{pmatrix}
1&0\\
0&9
\end{pmatrix}
\] なので、その逆行列は \[
S^{-1}
=
\begin{pmatrix}
1&0\\
0&1/9
\end{pmatrix}.
\] この重みを使うと、GMM は \[
(\bar A-\theta)^2+\frac19(\bar B-\theta)^2
\] を最小化する。したがって \[
\hat\theta_{S^{-1}}
=
\frac{\bar A+(1/9)\bar B}{1+1/9}
=0.9\bar A+0.1\bar B
\] になる。精度の高い \(\bar A\) を 90%、精度の低い \(\bar B\) を 10% だけ使っている。
この推定量の分散は \[
\operatorname{Var}(\hat\theta_{S^{-1}})
=
0.9^2\frac1n+0.1^2\frac9n
=
\frac{0.9}{n}
\] である。単位行列で同じ重みを置いたときの \(2.5/n\) より、かなり小さい。
この例が示していることは単純である。
noisy なモーメントを、信頼できるモーメントと同じ重さで使うと、推定量が無駄に揺れる。
weighting matrix は、この問題を避けるためにある。モーメントのノイズが大きい方向には小さい重みを置き、ノイズが小さい方向には大きい重みを置く。
相関したモーメントを二重に数えない
weighting matrix のもう 1 つの役割は、モーメント間の相関を調整することである。
例えば 2 つのモーメントがほとんど同じ情報を持っているとする。このとき、両方を独立な情報であるかのように同じ重さで使うと、同じ情報を二重に数えているような形になる。逆に、2 つのモーメントがあまり相関していないなら、それぞれが別の情報を持っているので、両方を使う価値が高い。
この 2 つをまとめて処理するのが \[
W=S^{-1},
\qquad
S=\operatorname{Var}\!\left(\sqrt n\,g_n(\theta_0)\right)
\] という選択である。\(S\) はモーメントのノイズの分散共分散行列であり、\(S^{-1}\) を使うことは、ノイズの大きい方向を弱く、ノイズの小さい方向を強く見ることに対応する。また、モーメント間の相関も補正する。
したがって、GMM における weighting matrix は単なる技術的な飾りではない。over identified な状況で、複数のモーメントをどれくらい信用して、どう組み合わせるかを決める中心的な部品である。
一致性
推定量 \(\hat\theta\) が 一致 するとは \[
\hat\theta \to_p \theta_0
\] が成り立つことである。これは、標本サイズが大きくなるにつれて、\(\hat\theta\) が真の値 \(\theta_0\) に高い確率で近づくことを意味する。
極値推定量の一致性の本質は、
- 母目的関数 \(Q\) が \(\theta_0\) で十分きれいに最大化されていること
- 標本目的関数 \(Q_n\) が \(Q\) に一様に近づくこと
の 2 点に尽きる。
定理 1 (極値推定量の一致性) 次を仮定する。
- clean maximum:任意の \(\delta>0\) に対して \[
\sup_{\theta\in\Theta:\,\|\theta-\theta_0\|\geq \delta} Q(\theta) < Q(\theta_0).
\]
- uniform convergence: \[
\sup_{\theta\in\Theta} |Q_n(\theta)-Q(\theta)| = o_p(1).
\]
このとき、定義 1 の意味で定義された任意の極値推定量 \(\hat\theta\) は一致する。すなわち \[
\hat\theta \to_p \theta_0.
\]
証明. 任意の \(\delta>0\) を固定する。clean maximum より \[
\varepsilon
=Q(\theta_0)-\sup_{\theta\in\Theta:\,\|\theta-\theta_0\|\geq \delta}Q(\theta)
>0
\] である。
次の事象を考える。 \[
S_n=
\left\{
|\eta_n|<\frac{\varepsilon}{3},\
\sup_{\theta\in\Theta}|Q_n(\theta)-Q(\theta)|<\frac{\varepsilon}{3}
\right\}.
\] 仮定より \(P(S_n)\to 1\)。
\(S_n\) 上で何が起きるかを、一つずつ確認する。
まず、一様収束の事象 \[
\sup_{\theta\in\Theta}|Q_n(\theta)-Q(\theta)|<\frac{\varepsilon}{3}
\] が成り立っているので、任意の \(\theta\) について \[
Q(\theta)>Q_n(\theta)-\frac{\varepsilon}{3},
\qquad
Q_n(\theta)>Q(\theta)-\frac{\varepsilon}{3}
\] である。特に \(\theta=\hat\theta\) と \(\theta=\theta_0\) に対してこの不等式を使える。
したがって、まず \(\theta=\hat\theta\) で評価すると \[
Q(\hat\theta)
>
Q_n(\hat\theta)-\frac{\varepsilon}{3}.
\] 次に、\(\hat\theta\) は \(Q_n\) をほぼ最大化するので、式 1 より \[
Q_n(\hat\theta)
\ge
Q_n(\theta_0)-\eta_n
\] である。ここでは、\(\theta_0\) も \(\Theta\) の中の候補の一つなので、 \[
\sup_{\theta\in\Theta}Q_n(\theta)\ge Q_n(\theta_0)
\] を使っている。
さらに \(S_n\) 上では \(|\eta_n|<\varepsilon/3\) なので、とくに \(\eta_n<\varepsilon/3\) である。したがって \[
Q_n(\theta_0)-\eta_n-\frac{\varepsilon}{3}
>
Q_n(\theta_0)-\frac{2\varepsilon}{3}.
\] 最後に、もう一度一様収束を \(\theta=\theta_0\) で使うと \[
Q_n(\theta_0)>Q(\theta_0)-\frac{\varepsilon}{3}.
\] 以上をつなげると \[
Q(\hat\theta)
>
Q(\theta_0)-\varepsilon.
\]
ここで \(\varepsilon\) の定義から \[
Q(\theta_0)-\varepsilon
=
\sup_{\theta\in\Theta:\,\|\theta-\theta_0\|\geq \delta}Q(\theta)
\] である。したがって \[
Q(\hat\theta) > \sup_{\theta\in\Theta:\,\|\theta-\theta_0\|\ge \delta} Q(\theta).
\] よって \(S_n\) 上では必ず \(\|\hat\theta-\theta_0\|<\delta\) である。ゆえに \[
P(\|\hat\theta-\theta_0\|<\delta)\ge P(S_n)\to 1.
\] \(\delta>0\) は任意だから、\(\hat\theta\to_p\theta_0\) が従う。
識別は通常 \[
Q(\theta_0)>Q(\theta) \qquad (\theta\neq\theta_0)
\] という一点ごとの比較で表される。他方、clean maximum は
\(\theta_0\) から一定距離以上離れた点では、\(Q\) が一様に低い
ことを要求する。したがって clean maximum は識別より少し強い条件であり、“遠く離れたところで \(Q(\theta)\) が \(Q(\theta_0)\) に限りなく近づく” ような病的な状況を排除する。
clean maximum の検証
clean maximum を直接検証する代わりに、より使いやすい十分条件を使うことが多い。
補題 1 (clean maximum の十分条件) 次を仮定する。
- \(\Theta\) はコンパクトである。
- \(Q:\Theta\to\mathbb{R}\) は連続である。
- \(Q(\theta_0)>Q(\theta)\) がすべての \(\theta\neq\theta_0\) について成り立つ。
このとき clean maximum が成り立つ。
証明. 任意の \(\delta>0\) を固定する。集合 \[
A_\delta=\{\theta\in\Theta:\|\theta-\theta_0\|\ge \delta\}
\] はコンパクトである。\(Q\) は連続だから、Weierstrass の定理より \(A_\delta\) 上で最大値をとる点 \(\theta_\delta^*\in A_\delta\) が存在する。すると \[
\sup_{\theta\in A_\delta}Q(\theta)=Q(\theta_\delta^*).
\] しかし \(\theta_\delta^*\neq\theta_0\) なので、仮定 3 より \[
Q(\theta_\delta^*)<Q(\theta_0).
\] したがって clean maximum が従う。
M 推定量の一致性
ここまでの結果をまとめると、M 推定量について次が得られる。
定理 2 (M 推定量の一致性) \(\hat\theta\) が \[
Q_n(\hat\theta)\ge \sup_{\theta\in\Theta}Q_n(\theta)-\eta_n,
\qquad \eta_n=o_p(1)
\] を満たし、 \[
Q_n(\theta)=\frac1n\sum_{t=1}^n m(X_t;\theta)
\] とする。次を仮定する。
- \(X_1,\ldots,X_n\) は独立同分布である。
- \(\Theta\) はコンパクトである。
- \(m(X_t;\theta)\) は \(\theta\) で連続である。
- \[
E[\sup_{\theta\in\Theta}|m(X_t;\theta)|]<\infty.
\]
- 母目的関数 \(Q(\theta)=E[m(X_t;\theta)]\) は \(\theta_0\) で一意に最大化される。
このとき \[
\hat\theta\to_p\theta_0.
\]
証明. 仮定 2, 3, 5 と 補題 1 より clean maximum が成り立つ。仮定 2–4 と 補題 3 より関数族 \(\mathcal M\) は有限ブラケット数をもち、仮定 1 と 補題 2 より uniform convergence が成り立つ。したがって 定理 1 を適用すればよい。
GMM の一致性
GMM では、一様収束の対象は標本モーメント \(g_n(\theta)\) である。
定理 3 (GMM 推定量の一致性) GMM の標本目的関数を \[
Q_n(\theta)=-\frac12 g_n(\theta)'\widehat W_n g_n(\theta),
\qquad
g_n(\theta)=\frac1n\sum_{t=1}^n g(X_t;\theta)
\] とする。さらに \[
g(\theta)=E[g(X_t;\theta)]
\] とおく。次を仮定する。
- \(X_1,\ldots,X_n\) は独立同分布である。
- \(\Theta\) はコンパクトである。
- \(g(\theta)\) は連続である。
- \(\widehat W_n\to_p W\)。ただし \(W\) は正定値対称行列である。
- \(g(\theta)=0\) であることと \(\theta=\theta_0\) であることが同値である。
- \[
\mathcal G=\{g_k(\cdot;\theta):\theta\in\Theta,\ 1\le k\le K\}
\] は有限ブラケット数をもつ。
このとき GMM 推定量 \(\hat\theta\) は一致し、 \[
\hat\theta\to_p\theta_0.
\]
証明. 証明の骨格は 定理 1 の適用である。
まず仮定 3–5 より \[
Q(\theta)=-\frac12 g(\theta)'Wg(\theta)
\] は \(\theta_0\) で一意に最大化され、かつ連続である。したがって 補題 1 により clean maximum が成り立つ。
次に、仮定 6 と 補題 2 を各成分 \(g_k(X_t;\theta)\) に適用すると \[
\sup_{\theta\in\Theta}\|g_n(\theta)-g(\theta)\|\to_p 0
\] が得られる。これを用いて \[
2\{Q(\theta)-Q_n(\theta)\}
= g_n(\theta)'(\widehat W_n-W)g_n(\theta)
+\bigl(g_n(\theta)-g(\theta)\bigr)'W\bigl(g_n(\theta)+g(\theta)\bigr)
\] と分解すれば、右辺第 1 項も第 2 項も \(o_p(1)\) であることがわかる。したがって uniform convergence が成立する。
以上より 定理 1 から結論が従う。